Shopify-Übersetzung mit zweiter Meinung
Übersetze deinen Shopify-Shop mit deinem eigenen KI-Schlüssel. Und lass eine zweite KI jede Zeile prüfen.
Glotari übersetzt mit deinem Schlüssel, danach liest eine andere Modellfamilie jedes Feld nach und gibt dir einen Score, mit dem du arbeiten kannst. Dein Fachglossar wächst mit jedem Auftrag.
Kostenloser Plan, keine Karte nötig. Der Judge prüft 50 Felder im Monat, auf uns.
- Stichprobe
- 240 Felder
- Sprachpaar
- Englisch → Deutsch
- Geprüft
- vor 2 Minuten geprüft
So arbeitet Glotari
Drei Schritte. Keine Blackbox.
- 01
Shop und KI-Schlüssel verbinden.
Aus dem Shopify App Store installieren, deinen Schlüssel von OpenAI, Anthropic, Google Gemini oder DeepL hinterlegen, oder Credits der Plattform nutzen.
- 02
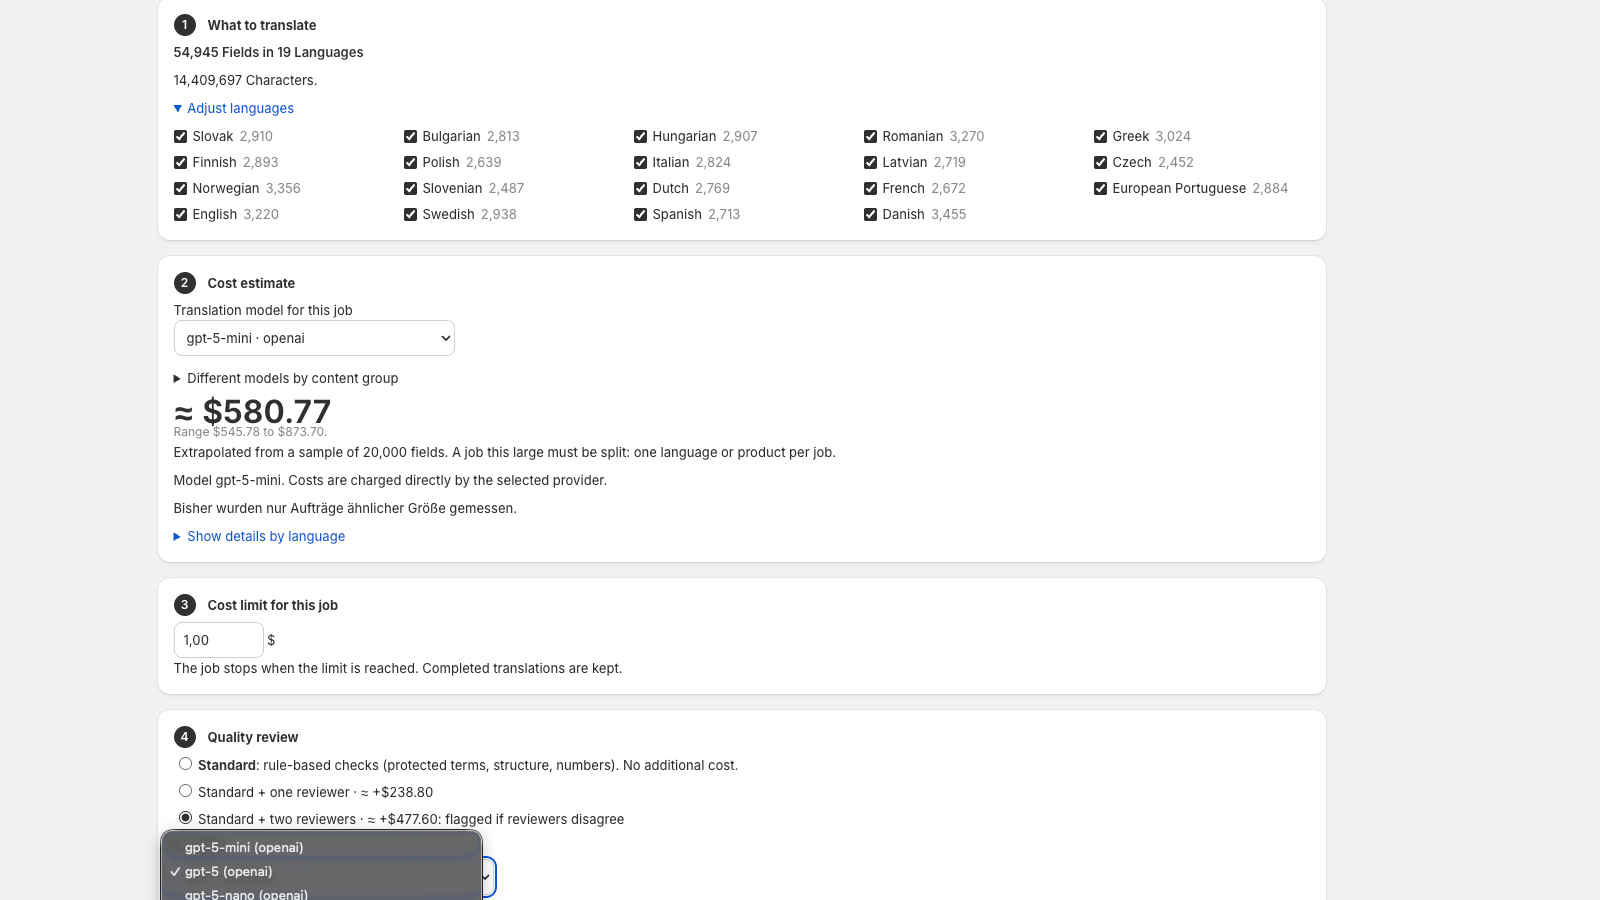
Auftrag starten, mit Kostenvorschau in echten USD.
Sprachen und Inhalte wählen. Glotari zeigt vorher, was übersetzt wird, was aus dem Speicher kommt und was es kostet.
- 03
Bericht lesen, freigeben was du willst.
Eine zweite KI prüft jedes Feld. Du siehst einen Score je Sprache, einen Befund je Fund und einen Klick zum Korrigieren, neu Übersetzen oder Ignorieren.
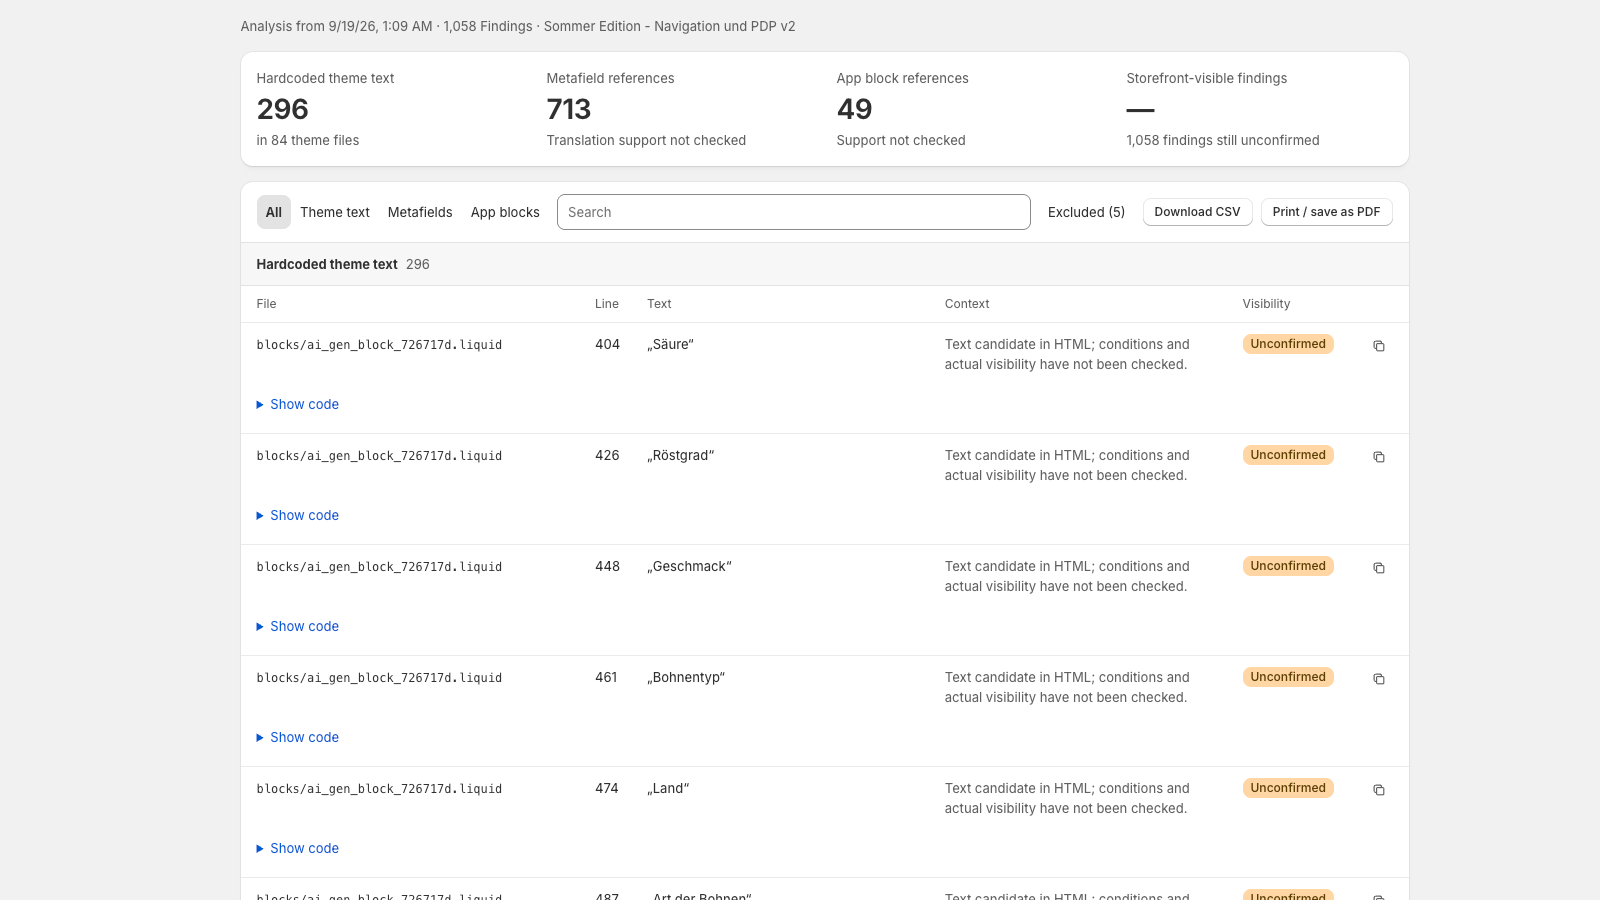
Unabhängige Prüfung, Feld für Feld
Jede Übersetzung bekommt eine zweite Meinung aus einer anderen Modellfamilie.
Ein Judge aus einer anderen Modellfamilie liest die Quelle, liest die Übersetzung und schreibt einen Befund. Falsche Zahlen, kaputtes HTML, übersetzte Markennamen und verschobene Bedeutung fallen auf, bevor deine Kunden sie sehen.
Quelle: Glotari Testshop, Judge-Befunde, September 2026
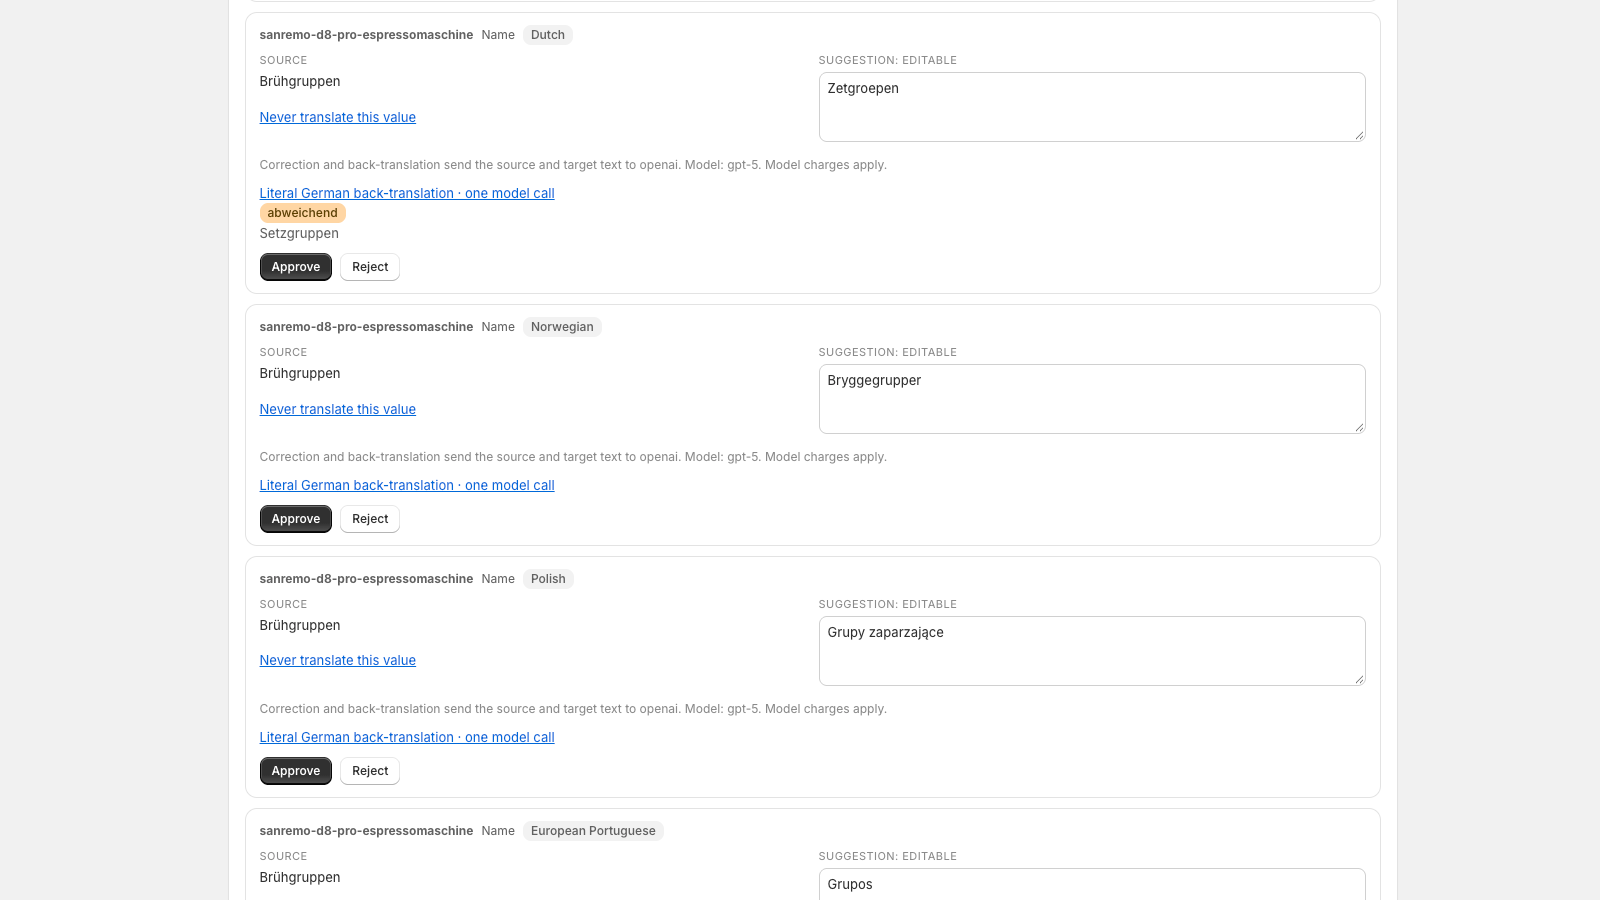
Eine andere Modellfamilie ist die Voreinstellung, keine Zusicherung von Richtigkeit.
Ein Speicher, der sich auszahlt
Zahle nie zweimal für denselben Satz.
Jede freigegebene Übersetzung landet in deinem Speicher. Der nächste Auftrag nutzt sie wieder. Die Ersparnis steht in der Kostenvorschau und im Journal als echter Dollarbetrag, nicht als vager Credit.
- 10.019
- Felder aus dem Speicher, 30 Tage
- 86
- Übersetzungsaufträge im selben Zeitraum
Praxisbeispiel Naturbohne, 19 Sprachen, 23.09. bis 22.10.2026.
Dein Shop hat seine eigene Sprache
Glotari lernt die Begriffe, auf die es in deinem Katalog ankommt.
Produktnamen, Röstgrade, Materialien, Maße, Pflegehinweise, Markensprache und Versandregeln bestimmen mit, woran eine Übersetzung gemessen wird.
- Prüfe Übersetzungen, egal woher sie kommen.
- Bau dein Glossar auf, wenn du so weit bist.
Prüfe jede Übersetzung. Halte die Sprache deines Shops zusammen.
FACHWISSEN
„Röstung Nr. 3"
- Besser
- Roast No. 3
- Vermeiden
- Roasting No. 3
Status: in der Prüfung verwendet
Stilregeln
Ton und Ansprache für den ganzen Shop.
Nie übersetzen
Produktnamen und Marken bleiben wörtlich stehen.
Fachglossar
Begriffspaare 1 zu 1, eine Zeile je Sprache.
Fachgebiet
Dein Gebiet, für jedes Modell im Ablauf.
Dein eigener KI-Schlüssel
Echte USD-Kosten. Getrennte Zeilen für Übersetzen und Prüfen.
Nutze deinen Schlüssel von OpenAI, Anthropic, Google Gemini oder DeepL und zahle dem Modell direkt seinen veröffentlichten Preis. Lieber eine Rechnung? Dann nimm Glotari Credits (≈ USD) mit offener Marge. So oder so siehst du vor jedem Auftrag eine Vorschau in echten Dollar, und dein Journal führt Übersetzen und Prüfen getrennt.
OpenAI · Anthropic · Google Gemini · DeepL · Credits (≈ USD)
Warum Händler Glotari nehmen
Wir zeigen die Arbeit.
- 26.193
- neue Übersetzungsvorschläge geprüft, 30 Tage
- 450
- Funde zu Zahlen, Einheiten oder Daten in 130 Feldern, vor der Veröffentlichung
- 10.019
- Felder aus dem Speicher übernommen, 30 Tage
Praxisbeispiel Naturbohne, 19 Sprachen, Glotari-Prüfdaten vom 23.09. bis 22.10.2026. Ein Shop, kein Durchschnitt über Kunden. Die Funde sind eine Untergrenze: Bereits korrigierte Felder zählen nicht mehr mit.
Was Glotari kann und andere Shopify-Übersetzungs-Apps nicht.
Fünf Fähigkeiten, die bei Glotari Standard sind und anderswo selten oder gar nicht vorkommen. Die Namen der Wettbewerber stehen bewusst nicht da, wir treten über die Arbeit an und nicht über den Streit.
| FÄHIGKEIT | GLOTARI | W*** | T*** | L*** | S*** |
|---|---|---|---|---|---|
| Zweite KI prüft jede Übersetzung | Ja | Nein | Nein | Nein | Nein |
| Öffentlicher Score mit Methode | Ja | Nein | Nein | Nein | Nein |
| Eigener Schlüssel mit echter USD-Vorschau | Ja | Eingeschränkt | Nein | Nein | Eingeschränkt |
| Ersparnis aus dem Speicher als Geldbetrag | Ja | Nein | Nein | Nein | Nein |
| Automatisches Glossar mit Quellenangabe | Ja | Nein | Nein | Nein | Nein |
Ja: heute in Glotari im Einsatz. Nein: von dieser App zum Zeitpunkt des Vergleichs nicht angeboten. Eingeschränkt: teilweise und unter Bedingungen verfügbar. Nicht veröffentlicht: keine öffentliche Aussage auf den Produktseiten oder im Listing gefunden.
Die Kürzel stehen für bekannte Shopify-Übersetzungs-Apps. Die vollen Namen nennen wir im Gespräch.
Vergleich aus öffentlichen Produktseiten und App-Store-Listings, Stand 20.09.2026. Hat ein Wettbewerber seither eine Fähigkeit veröffentlicht, aktualisieren wir diese Tabelle innerhalb von sieben Tagen nach Bestätigung. Korrekturen an hello@klariton.com.
Preise
Kostenlos starten. Wechseln, wenn du so weit bist.
Free
$0 im Monat
50 vom Judge geprüfte Felder im Monat, auf uns. Score-Prüfung und Shop-Analyse enthalten. Free prüft und analysiert, übersetzt wird ab Starter.
Starter
$14 im Monat
140 $ im Jahr
Eigener Schlüssel ohne Wortgrenze. 2 Zielsprachen. 100 Judge-Prüfungen im Monat. Translation Memory und Glossar.
- EMPFOHLEN
Growth
$29 im Monat
290 $ im Jahr
5 Zielsprachen. Judge-Prüfungen ohne Grenze. Modellwahl je Auftrag. Automatisch übersetzen bei Produktänderung. Metafelder ausschliessen. Translation Memory über mehrere Shops.
Pro
$79 im Monat
790 $ im Jahr
20 Zielsprachen. Prüfaufträge für bestehende und fremde Übersetzungen. Bevorzugter Support.
BYOK-Kosten zahlst du deinem Modellanbieter zu seinem Listenpreis. Credits werden als Credits (≈ USD) mit offener Marge abgerechnet. Kündigen jederzeit über deine Shopify-Abrechnung.
Häufige Fragen
Was genau findet der Judge, erkennt er auch subtile Fehler wie falsche Zahlen oder übersetzte Markennamen?
Genau das sind die Stärken. Vier der fünf schwersten Befundarten, fehlende Übersetzung, identisch mit Original, abweichende Zahlen, zerstörte HTML-Struktur, kommen aus deterministischen Prüfungen mit Gewicht 1,0. Übersetzte Markennamen aus deiner Glossar-Liste tragen 0,8. Der Judge aus einer zweiten Modellfamilie ergänzt Sinn, Grammatik und Ton. Alles landet mit Schweregrad und Begründung im Befund.
Löst der Judge eigene Modellaufrufe aus, und wer zahlt dafür?
Vier der fünf schwersten Befundarten (fehlende Übersetzung, identisch mit Original, abweichende Zahlen, zerstörtes HTML) sind deterministische Checks, kein Modellaufruf, keine Tokenkosten. Nur semantische Prüfungen (Sinn, Grammatik, Ton) rufen den Judge-Modell auf. Im kostenlosen Plan übernehmen wir 50 Judge-Prüffelder pro Monat. Darüber hinaus läuft der Judge über unser eigenes Kontingent, dein OpenAI-Key wird für die Übersetzung genutzt, nicht für den Judge.
Löst der Translation Score bei jeder Berechnung einen eigenen API-Aufruf aus, und kostet das Credits?
Nein. Der Score löst keinen eigenen Modellaufruf aus. Er aggregiert Befunde, die der Judge je Feld bereits erzeugt hat, Kategorie, Schweregrad, Begründung. Die Score-Berechnung selbst ist kostenlos, egal ob du einen Auftrag, eine Sprache, den ganzen Shop oder einen Zeitraum auswertest. Token-Kosten fallen nur beim Judge-Run an, nicht beim Score-Abruf.
Wie lange sind die Judge-Befunde gespeichert, auf denen der Score basiert, und kann ich historische Scores für Zeiträume abfragen?
Befunde werden 90 Tage aufbewahrt. Innerhalb dieses Fensters kannst du den Score für beliebige Aggregationen berechnen, Auftrag, Sprache, Shop oder Zeitraum. Die Formel ist deterministisch: Score = 100 × (1 − Σgᵢ / n). Für Versionierung und Routing nach Risikoklassen hast du also 90 Tage historischen Spielraum.
Greift der Judge selbst in Metafields oder Theme-Dateien ein, oder liest er nur?
Der Judge liest, er schreibt nichts zurück. Er erzeugt Befunde mit Kategorie und Schweregrad; du entscheidest danach per Klick: korrigieren, neu übersetzen oder ignorieren. Das Write-Back läuft ausschließlich über die Übersetzungs-Funktion mit deinem eigenen OpenAI-Key. Dein Theme und deine Metafields bleiben unter deiner vollen Kontrolle.
Wie schnell sehe ich, ob meine Übersetzungen okay sind?
Der Score erscheint direkt nach der Prüfung, im Beispiel: 2 Minuten nach dem Auftrag. Du siehst einen Score je Sprache und pro Feld einen konkreten Befund mit Begründung. Falsche Zahlen, kaputtes HTML und übersetzte Markennamen werden separat ausgewiesen, nicht in einer unübersichtlichen Liste.
Greift ihr ins Theme oder in Metafields ein, und wann genau schreibt ihr zurück?
Wir lesen Theme und Metafields als Quelle. Zurückgeschrieben wird ausschließlich nach ausdrücklicher Freigabe durch dich. Vor jedem Schreibvorgang prüfen wir, ob sich Quelle oder Zieltext geändert haben. Kein automatisches Überschreiben ohne deine Freigabe.
Kann ich den Translation Score kostenlos testen, ohne eine Kreditkarte anzugeben?
Ja. Im Free-Plan prüfen wir 50 Felder in einer Zielsprache, ohne Karte, ohne Vorabkosten. Du installierst Glotari auf Shopify, und der Score-Check läuft direkt los. Das Ergebnis siehst du als Zahl von 0–100, aufgeschlüsselt nach Befundart und Schweregrad.
Wie verhält sich Glotari zu unserem bestehenden GraphQL-Workflow mit translationsRegister?
Glotari ersetzt deinen bestehenden Workflow nicht, es ergänzt ihn. Die App schreibt über die native Shopify Translations API zurück und ordnet Übersetzungen der korrekten Sprache je Markt zu. Deine eigene translationsRegister-Pipeline bleibt unberührt. Metafields, Theme-Strings und Checkout Extensibility Strings werden als separate Quelltypen behandelt.
Was genau prüft der Judge bei meinen Produktfeldern?
Der Judge liest Quelle und Übersetzung parallel und prüft: fehlende Übersetzung, identischer Text, abweichende Zahlen, zerstörtes HTML und übersetzte Markennamen, alle deterministisch, ohne Extrakosten. Dazu bewertet er Sinn, Grammatik und Ton. Jeder Befund hat ein Gewicht: falsche Zahlen zählen 1,0, Grammatik nur 0,3.
Ab wie vielen geprüften Feldern ist der Score wirklich aussagekräftig?
Unter 30 Feldern zeigen wir den Score grau und als vorläufig markiert. Ab 30 Feldern erscheint ein Band mit Stichprobengröße. Ab 200 Feldern entfällt dieser Zusatz, die Stichprobe spricht für sich. Mit dem Free-Plan (50 Felder) landest du im mittleren Bereich: ein guter Indikator, kein Vollbild. Für den vollständigen Shop-Check lohnt sich der Starter-Plan mit 100 Judge-Prüfungen pro Monat.
Wie genau wird der Score berechnet, welche Formel steckt dahinter?
Die Formel lautet: Score = 100 × (1 − Σ gᵢ / n). Dabei ist n die Anzahl geprüfter Felder, gᵢ das Gewicht des schwersten Befunds pro Feld. Ein Feld ohne Befund trägt 0 bei. Mehrere Befunde im selben Feld zählen nur einmal mit dem höchsten Gewicht, so dominiert kein einzelnes kaputtes Feld das Gesamtergebnis. Der Score ist eine Aggregation der ohnehin erzeugten Befunde und löst keinen zusätzlichen Modellaufruf aus.
Welche Befundarten gibt es und wie sind sie gewichtet?
Es gibt acht aktive Befundarten in score.version 1: Übersetzung fehlt komplett (1,0), Identisch mit Original (1,0), Zahlen weichen ab (1,0), HTML-Struktur zerstört (1,0), Begriff aus 'nie übersetzen' wurde übersetzt (0,8), Sinn beanstandet (0,7), Grammatik beanstandet (0,3), Ton oder Stil beanstandet (0,15). Vier davon sind deterministisch, kein Modellaufruf, keine Kosten. Die Gewichte sind versioniert; jede Änderung erzeugt eine neue Version, alte Scores bleiben unverändert.
Wie funktioniert die zweite KI-Prüfung, was prüft der Judge konkret, und wie entsteht daraus ein Score?
Unser Judge ist eine zweite KI, die jede Übersetzung unabhängig vom übersetzenden Modell bewertet. Das Ergebnis fließt in einen öffentlichen Score mit dokumentierter Methode, du siehst nicht nur die Zahl, sondern wie sie zustande kommt. Übersetzen und Prüfen werden im Journal getrennt ausgewiesen, sodass du Befunde feldgenau nachvollziehen kannst. Der Score ist kein Bauchgefühl, sondern auditierbar.
Wer hat Zugriff auf meine Übersetzungsdaten, wenn ich meinen eigenen OpenAI-Schlüssel nutze, und wie ist das DSGVO-konform dokumentierbar?
Mit deinem eigenen Schlüssel (BYOK) läuft der Datenfluss direkt zwischen deinem Shop und deinem Modellanbieter. Wir speichern keine Übersetzungen bei Dritten außerhalb deines gewählten Modellanbieters. Wir schreiben nur nach ausdrücklicher Freigabe in Shopify zurück. Das ist dokumentierbar: Du kontrollierst den Schlüssel, du steuerst die Freigaben, DSGVO-Verantwortlichkeit bleibt klar bei dir.
Schreibt Glotari Menü-Übersetzungen automatisch zurück oder muss ich erst freigeben?
Wir schreiben nur nach ausdrücklicher Freigabe. Kein Auto-Publish-Risiko. Vor jedem Schreibvorgang prüfen wir, ob sich Quelle oder Zieltext geändert haben, so gehen keine ungewollten Änderungen live. Du behältst die volle Kontrolle über jeden Menü-Eintrag, bevor er in der Storefront erscheint.
Schreibt Glotari Blog-Übersetzungen automatisch live, oder muss ich das explizit freigeben?
Wir schreiben ausschließlich nach ausdrücklicher Freigabe zurück. Kein Auto-Publish ohne dein Go. Vor jedem Schreibvorgang prüfen wir, ob sich Quelle oder Zieltext verändert haben. Übersetzungen werden nicht bei Dritten außerhalb deines Modellanbieters gespeichert. Du behältst vollständige Kontrolle über jeden Schritt des Rollouts.
Kann ich beim Menü-Rollout einzelne Sprachen nacheinander freischalten statt alles auf einmal?
Ja. Im Starter-Plan startest du mit 2 Zielsprachen (14 $/Monat), im Growth-Plan erweiterst du auf 5. Du übersetzt, prüfst den Score und gibst Sprache für Sprache frei. So verteilst du Budget und Qualitätsprüfung auf mehrere Rollout-Phasen, ohne von Anfang an alles buchen zu müssen.
Kann ich Translation Memory auch für Kollektionen nutzen, und sehe ich konkret, was das spart?
Ja. Das Translation Memory greift über alle Inhaltstypen, Kollektionen eingeschlossen. Wiederverwendete Felder werden nicht erneut übersetzt und kosten nichts. Im Journal siehst du die gesparte Summe als Geldbetrag, unser Magazin zeigt ein Beispiel: 2.418 Felder wiederverwendet, 37,20 Credits (≈ USD) nicht ausgegeben.
Werden Kollektionen wirklich vollständig über Shopify Markets abgebildet, inklusive korrekter Sprachzuordnung je Markt?
Ja, und das ist einer der Kernpunkte unserer Shopify-Markets-Integration. Wir lesen Kollektionsinhalte, übersetzen sie, prüfen sie per Judge und schreiben sie direkt in den richtigen Sprachslot je Markt zurück. Die Sprachzuordnung erfolgt automatisch, kein manuelles Nachpflegen in Translate & Adapt. Titel, Beschreibungen und Metafelder werden dabei sauber getrennt behandelt.
Wie fügt sich die Menü-Übersetzung konkret in Shopify Markets ein, landen die Texte automatisch in der richtigen Sprache je Markt?
Ja, genau das ist unser Kernmechanismus: Wir ordnen jede Übersetzung der korrekten Sprache je Markt zu. Menü-Einträge werden gelesen, übersetzt, geprüft und erst nach ausdrücklicher Freigabe zurückgeschrieben. Kein unkontrolliertes Überschreiben, kein falsches Mapping. Für euren Workflow bedeutet das: Navigation ist marktkonform ohne manuelle Nacharbeit.
Kann ich meinen eigenen OpenAI-Schlüssel nutzen, und was kostet mich das bei Blog-Inhalten in mehreren Sprachen?
Ab dem Starter-Plan (14 $/Monat) nutzt du deinen eigenen Schlüssel ohne Wortgrenze. BYOK-Kosten zahlst du direkt deinem Modellanbieter zu seinem Listenpreis. Unser Magazin-Artikel rechnet das konkret für einen Shop mit 400 Produkten in zwei Sprachen durch, inklusive Translation-Memory-Ersparnis. Für 5 Sprachen und automatisches Übersetzen bei Produktänderung empfehlen wir den Growth-Plan bei 29 $/Monat.
Ist der Translation Score ein echter KPI oder nur eine grobe Einschätzung, kann ich damit vor dem Launch Risiken gegenüber Stakeholdern belegen?
Der Score ist öffentlich dokumentiert mit offengelegter Methode, kein Blackbox-Wert. Eine zweite KI prüft jede Übersetzung unabhängig. Das Ergebnis ist aufgeschlüsselt, nicht nur ein Gesamtwert. Ihr könnt damit konkret kommunizieren: Score unter einem Schwellenwert im Menü bedeutet Navigationsrisiko vor dem Launch, das ist stakeholder-tauglich.
Kann ich meinen eigenen OpenAI-API-Key hinterlegen, statt euer Credit-System zu nutzen?
Ja. Ab dem Starter-Plan hinterlegst du deinen eigenen Schlüssel, ohne Wortgrenze auf unserer Seite. Du zahlst OpenAI direkt zum Listenpreis, siehst Token-Kosten im OpenAI-Dashboard und behältst volle Transparenz über jede Engine und jeden Auftrag. Credits rechnen wir als Credits (≈ USD) mit offener Marge ab, BYOK ist die sauberere Wahl, wenn Nachvollziehbarkeit für dich nicht verhandelbar ist.
Gibt es ein Journal oder Audit-Trail für Menü-Übersetzungen, und wie lange bleiben Änderungen nachvollziehbar?
Wir führen ein Journal über jeden Übersetzungs- und Prüfschritt. Rücknahmen sind innerhalb von 90 Tagen möglich. Vor jedem Schreiben prüfen wir, ob sich Quell- oder Zieltext geändert haben, das verhindert stille Überschreibungen. Für euer Audit reicht das als Nachweisgrundlage für 3 Monate rückwirkend.
Kann ich meinen eigenen OpenAI-API-Key für die Menü-Übersetzung hinterlegen?
Ja. Ab dem Starter-Plan hinterlegst du deinen eigenen Schlüssel, ohne Wortgrenze. Deine Token-Kosten laufen direkt über dein OpenAI-Dashboard, du siehst jeden Request, jede Engine, jede Kostenkurve. Wir rechnen nichts versteckt ab. BYOK-Kosten zahlst du deinem Modellanbieter zu seinem Listenpreis.
Gibt es eine Rollback-Funktion, und wie schnell kann ich eine fehlerhafte Blog-Übersetzung zurücknehmen?
Übersetzungen lassen sich innerhalb von 90 Tagen zurücknehmen. Das Journal protokolliert jeden Schreibvorgang als nachvollziehbares Change-Paket. Für Checkout- oder rechtliche Texte, wo du in Minuten reagieren musst, empfehlen wir Score-Schwellenwerte so zu setzen, dass diese Inhalte erst nach manueller Freigabe live gehen, dann entsteht gar kein Rollback-Bedarf.
Was passiert, wenn eine Übersetzung falsch ist, kann ich die Änderung rückgängig machen?
Wir schreiben Inhalte nur nach deiner ausdrücklichen Freigabe zurück in den Shop. Hast du trotzdem einen Fehler bemerkt, greift unsere 90-Tage-Rücknahme: Wir stellen den Ursprungszustand wieder her. Vor jedem Schreiben prüfen wir außerdem, ob sich Quelle oder Zieltext seit der letzten Prüfung geändert haben.
Wie funktioniert der Rollback bei Menü-Einträgen, wenn eine Übersetzung fehlerhaft live geht?
Übersetzte Menü-Einträge lassen sich innerhalb von 90 Tagen zurücknehmen. Für operativ kritische Korrekturen, z.B. Checkout-nahe Navigation, empfehlen wir, die Freigabe manuell zu steuern: Wir schreiben nur auf explizite Freigabe hin, sodass fehlerhafte Versionen erst gar nicht live gehen.
Wie schnell sehe ich, ob meine Blog-Übersetzungen okay sind?
Wir lesen deine Blog-Inhalte direkt aus Shopify, prüfen sie mit einer zweiten KI und zeigen dir den Score. Kritische, kurze Felder prüfen wir zuerst, weil sie den meisten Schaden anrichten können. Du bekommst konkrete Befunde, keine vage Gesamtnote, sondern je Feld.
Erkennt ihr fremde App-Felder im Menü-Kontext, oder überschreibt ihr alles blind?
Wir erkennen fremde App-Felder und unterscheiden automatisch zwischen Übersetzen und Nicht-Übersetzen. Metafelder lassen sich gezielt ausschließen, das steuerst du pro Auftrag. Kein blindes Überschreiben von Feldern, die außerhalb des nativen Shopify-Schemas liegen.
Wie schnell sehe ich, ob meine bestehenden Kollektionsübersetzungen okay sind?
Nach der Installation liest Glotari deine Kollektionsinhalte direkt aus Shopify aus. Eine zweite KI, unser Judge, prüft jede Übersetzung und gibt dir einen öffentlichen Score mit offener Methode. Kritische, umsatzrelevante Strings prüfen wir zuerst. Du siehst konkrete Befunde, keine vagen Ampeln.
Wie lange bleiben Befunde einsehbar, und kann ich sie für ein Audit exportieren?
Wir garantieren die Rücknahme übersetzter Blog-Inhalte innerhalb von 90 Tagen. Befunde aus Judge-Prüfungen sind über diesen Zeitraum im Journal nachvollziehbar. Für strukturierte Exports in dein Audit-System bietet der Pro-Plan die Judge-API, darüber holst du Befunde mit Zeitstempel und Feld-Referenz in deine eigene Umgebung.
Gibt es ein Audit-Trail? Wenn eine Massenübersetzung schiefläuft, muss ich nachvollziehen können, was wann übersetzt wurde.
Jeder Auftrag landet im Journal, Übersetzen und Prüfen getrennt ausgewiesen, mit Kosten in echten Dollar. Translation Memory zeigt dir, welche Felder wiederverwendet wurden: im Testfall 2.418 Felder, 37,20 Credits nicht ausgegeben. Korrekturen aus der Prüfansicht bleiben gespeichert. So weißt du bei jedem Feld, ob es neu übersetzt, aus dem Speicher gezogen oder manuell korrigiert wurde.
Wie sehe ich, was Translation Memory konkret spart, in echten Zahlen, nicht in vagen Prozenten?
Das Journal führt jeden wiederverwendeten Speicher-Treffer als echten Dollarbetrag. Vor jedem Auftrag zeigt die Kostenvorschau, wie viele Felder aus dem Speicher kommen und was dadurch nicht abgerechnet wird. Ein dokumentiertes Beispiel aus unserem Magazin: 2.418 wiederverwendete Felder, 37,20 Credits nicht ausgegeben, mit vollständiger Quellenzeile.
Gibt es eine Rollback-Möglichkeit, wenn eine fehlerhafte Übersetzung live geht?
Jede freigegebene Übersetzung landet im Translation Memory als eigenständiges Paket. Der Judge flaggt Zahlenfehler, kaputtes HTML und verschobene Bedeutung vor der Veröffentlichung, das reduziert den Rollback-Bedarf erheblich. Korrekturen aus der Prüfansicht werden gespeichert, damit dasselbe Problem kein zweites Mal auftritt.
Welche Shopify-Inhaltstypen deckt ihr ab, konkret Produkte, Kollektionen und Navigationsmenüs?
Wir decken Produkte, Kollektionen, Seiten, Blog, Menü und Richtlinien vollständig ab. Dazu kommen Theme-Strings, Metafields und Checkout Extensibility Strings. Kritische kurze Strings, Navigation, Checkout, prüfen wir zuerst, weil sie den Umsatz direkt tragen.
Greift ihr ins Theme oder in Metafields ein, und wenn ja, wie sauber wird das zurückgeschrieben?
Wir lesen aus Theme und Metafields, schreiben aber nur nach ausdrücklicher Freigabe zurück. Vor jedem Schreibvorgang prüfen wir, ob sich Quelle oder Zieltext geändert haben. Bestehende Strukturen bleiben unangetastet, wir ersetzen keine vorhandenen Systeme, sondern ergänzen sie. Fremde App-Felder erkennen wir und übersetzen sie nur, wenn explizit freigegeben.
Wie arbeitet Glotari mit Shopify Markets zusammen, überschreibt es meine Markt-Konfiguration?
Glotari ordnet Übersetzungen der korrekten Sprache je Markt zu, ohne deine bestehende Markets-Konfiguration zu verändern. Wir schreiben ausschließlich Sprachinhalte, keine Markt-Settings, Preisregeln oder Versandprofile. Dein Setup bleibt exakt so, wie du es aufgebaut hast.
Was kostet mich die Übersetzung meiner Richtlinien und Rechtstexte, eigener Schlüssel oder Credits?
Im Magazin-Artikel vom 18.10.2026 rechnen wir das konkret durch: eigener OpenAI-Schlüssel zahlt zum Listenpreis deines Anbieters, keine Marge von uns. Credits rechnen wir als Credits (≈ USD) mit offener Marge ab. Für Rechtstexte, die selten ändern, lohnt der eigene Schlüssel besonders, du zahlst nur beim tatsächlichen Schreibvorgang. Wir prüfen vorher, ob sich Quelle oder Zieltext geändert haben, und übersetzen nur dann neu.
Prüft ihr die übersetzten Rechtstexte auch, oder ist das reine Maschinenübersetzung?
Eine zweite KI prüft jede Übersetzung automatisch, das ist unser Judge. Er bewertet Genauigkeit, Konsistenz und Markenstimme und erzeugt einen öffentlichen Score mit Methode. Gerade bei Rechtstexten, wo ein falscher Begriff rechtlich heikel wird, ist dieser zweite Blick entscheidend. Im Free-Plan prüft der Judge 50 Felder pro Monat kostenlos, du siehst sofort, wo Qualitätslücken sind.
Funktioniert das auch mit meinen bestehenden Seiten und Richtlinien, oder nur mit neuen Inhalten?
Das funktioniert mit deinen vorhandenen Inhalten. Wir lesen Shopify Core-Felder, Richtlinien, Rechtstexte, Seiten, direkt aus deinem Shop aus, prüfen sie über den Judge und schreiben die Übersetzungen nach Freigabe zurück. Bestehende Übersetzungen werden vor dem Überschreiben verglichen. Nichts geht verloren, was sich nicht geändert hat.
Ihr prüft Metafields, aber wie unterscheidet Glotari dabei, welche Felder übersetzt und welche unverändert bleiben müssen?
Wir erkennen fremde App-Felder automatisch und unterscheiden zwischen übersetzbaren und nicht-übersetzbaren Feldern. So landen keine technischen IDs oder App-internen Werte versehentlich im Übersetzungsprozess. Vor jedem Schreibvorgang prüfen wir zudem, ob sich Quelle oder Zieltext geändert haben, kein Feld wird ohne Grundlage überschrieben.
Wir haben sensible Produktdaten in Metafields, wer sieht die Übersetzungsinhalte während der Verarbeitung?
Wir speichern keine Übersetzungen bei Dritten außerhalb Ihres eigenen Modell-Anbieters. Die Daten laufen ausschließlich über den API-Schlüssel, den Sie selbst kontrollieren. Wenn Datenhoheit für Sie zentral ist, empfehle ich unseren Starter-Plan mit eigenem OpenAI-Schlüssel, so dokumentieren Sie selbst, welche Daten wohin gehen.
Wächst das Glossar automatisch, oder muss ich jedes Begriffspaar manuell pflegen?
Das Glossar wächst mit jedem Auftrag. Wir ziehen Begriffskandidaten aus deinen Produkten, recherchieren den Fachbegriff je Zielsprache und halten die Quellen fest. Du gibst frei, was reinkommt. Jede Korrektur aus der Prüfansicht bleibt gespeichert, dasselbe Wort wird nie zweimal falsch übersetzt. Kein manuelles Pflegen von CSVs, kein Import-Export.
Wie sehe ich konkret, wie viel das Translation Memory mir tatsächlich spart, in echten Dollar, nicht in vagen Credits?
Jede wiederverwendete Übersetzung aus dem Speicher zeigt dir die Ersparnis als echter Dollarbetrag, in der Kostenvorschau vor dem Auftrag und im Journal danach. Kein vager Credit-Zähler. Ein konkretes Beispiel: 2.418 wiederverwendete Felder entsprechen 37,20 Credits (≈ USD) nicht ausgegeben. Wie diese Zahl zustande kommt, erklären wir detailliert in unserem Magazin-Artikel zum Translation Memory.
Spart das Glossar mir bei weiteren Übersetzungen wirklich Geld, und sehe ich das auch konkret?
Jede freigegebene Übersetzung landet im Translation Memory. Beim nächsten Auftrag wird sie wiederverwendet. Die Ersparnis steht in der Kostenvorschau und im Journal als echter Dollar-Betrag, kein vager Prozentwert. Ein Beispiel aus unserem Magazin: 2.418 wiederverwendete Felder, 37,20 Credits nicht ausgegeben.